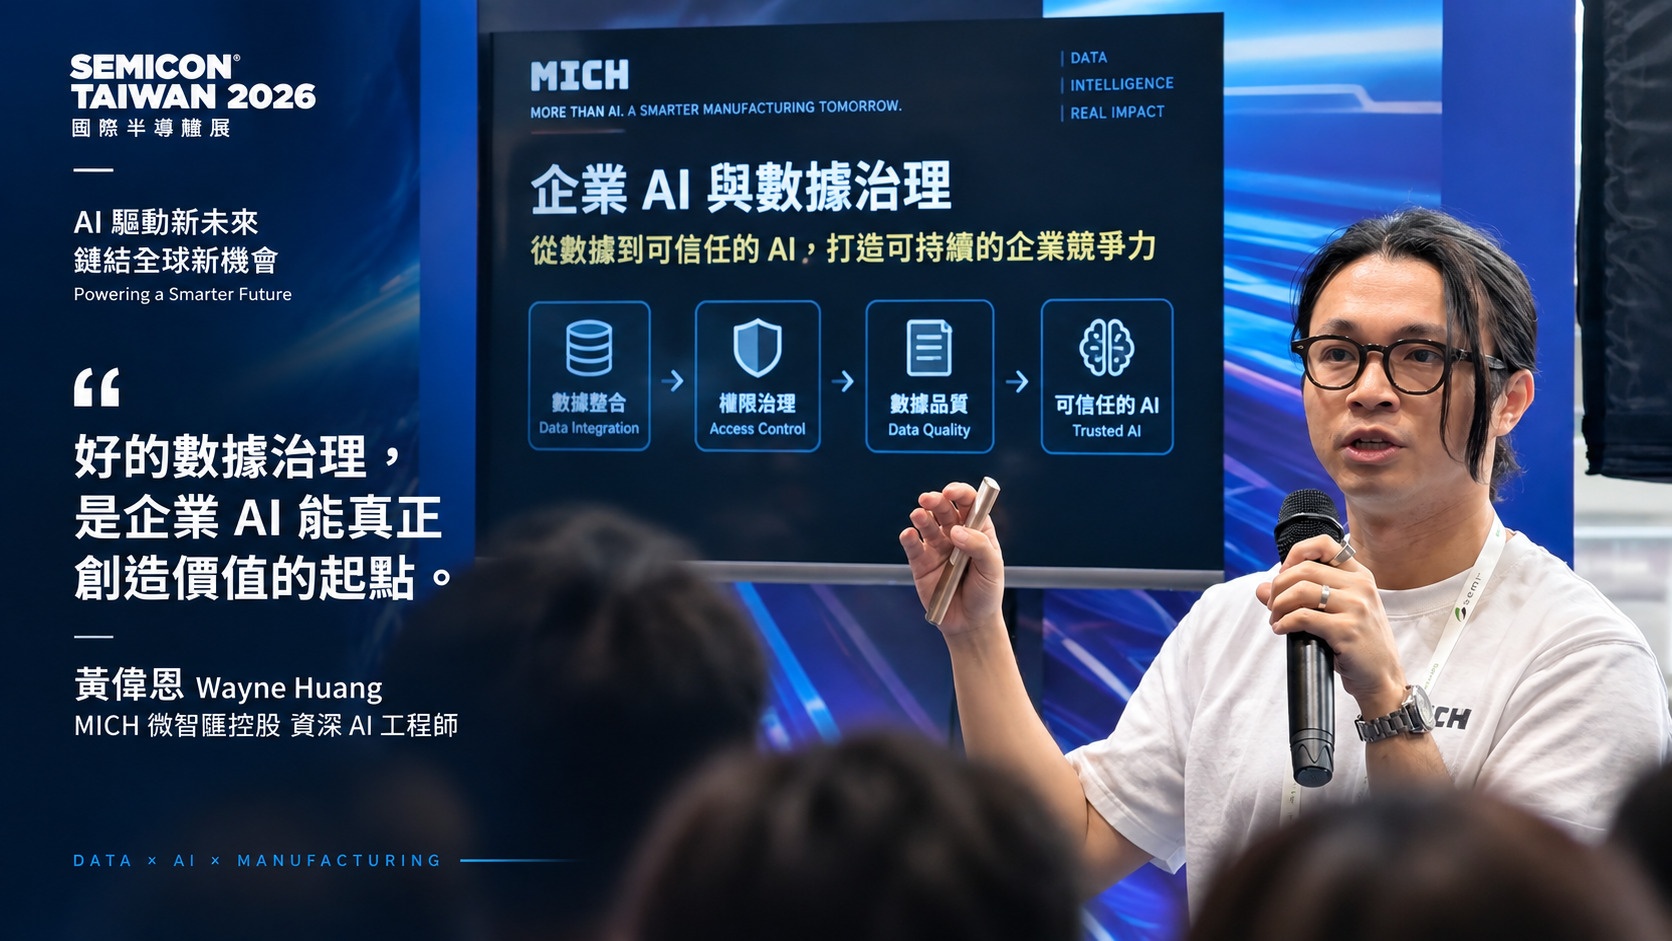
當 AI 開始連接 ERP、MES、SOP 與製程資料,模型只是整體架構中的其中一層。資料如何串接、欄位如何被理解、AI 能讀取哪些資訊,以及模型與 GPU 資源如何管理,都會直接影響企業 AI 能否真正進入 Production。
MICH Senior AI Engineer Wayne Huang 從工程架構角度指出,企業導入 AI 的核心,不應只是部署一套大型語言模型,而是建立一套能持續支撐不同 AI 應用的 Enterprise AI Infrastructure。
AI 專案真正耗時的工作,發生在模型推論之前
企業 AI 最常低估的成本之一,是 Data Engineering。
假設新的 APS 或 AI Agent 需要 18 張資料表,但企業既有 MES 有 50 張、ERP 又有 60 張,真正困難的並不是資料存不存在,而是如何從既有系統找出正確資料,完成 Schema Mapping、Transformation 與 Validation。
因此,AI 專案真正的瓶頸往往不是模型,而是模型之前的資料工程。
LowsiteOS 的 Data Agent,正是針對這類問題協助辨識來源資料、建立 Mapping 與 Transformation Pipeline;關鍵轉換則保留人工核准機制,透過 Human-in-the-loop 確保資料正確性。
核心原則不是讓 AI 取代工程師,而是:
AI 處理大量重複工程,人保留關鍵判斷與責任。
AI 讀得到資料,不代表理解資料
資料完成串接後,下一層問題是 Semantic Layer。
企業資料庫中的 Table 與 Column,往往是長年累積的系統設計結果。模型即使能讀取 Schema,也不代表知道每個欄位真正的業務意義。
尤其良率、OEE、Cycle Time 等指標,背後可能存在不同計算公式、排除條件與時間區間。
因此,企業 AI 需要的不只是 Data Catalog,而是能進一步定義 Table Semantic、Column Semantic 與 Metric Semantic 的資料基礎。
這也是降低 AI Hallucination 的重要環節之一:與其讓模型「猜」企業資料代表什麼,不如讓企業先把正確的語意提供給模型。
AI 也必須遵守企業原有的身分與權限
當 AI 開始存取企業核心資料,Identity Governance 也成為架構的一部分。
如果工程師原本只能查看 Fab A,透過 AI 查詢時,就不應因為後端使用高權限 Service Account,而意外取得 Fab B 的資訊。
因此,AI 不應成為企業權限制度之外的「超級帳號」。
更合理的設計,是讓 AI 的 Data Access 繼承使用者本人的 Identity 與 Permission,並留下完整的 Access Log。
也就是說:
使用者原本不能看的資料,透過 AI 一樣不能看。
這讓 AI 從單純的應用工具,正式納入企業既有的 Zero Trust 與資料治理架構。
地端 AI 的價值,不只是「資料不出廠」
On-Prem AI 經常被簡化成資安議題,但從工程角度來看,它更重要的價值其實是 Control。
企業不只掌握資料存放位置,也能控制 Model Version、API Endpoint、Permission、Log,以及 GPU Resource。
LowsiteOS 的 Model Layer 採用 OpenAI-compatible Endpoint,讓上層 AI Application 與底層 Model 解耦。
企業的 RAG、MES Copilot 或各類 AI Agent,不必永久綁定特定模型;底層模型可以隨需求調整,上層應用與既有 Data Layer 則持續保留。
這對模型快速迭代的 AI 市場尤其重要。
企業真正需要累積的資產,不只是某一個模型,而是自己的數據、語意、權限與應用架構。
從模型管理進一步走向 GPU 資源管理
地端部署之後,另一項實際工程問題是 GPU VRAM。
企業未來通常不會只有單一模型,不同 Agent、RAG、Vision 或推論工作都可能需要不同模型。如果所有模型長時間占用 GPU Memory,硬體資源很快就會成為新的瓶頸。
因此,Model Layer 還需要處理模型生命週期管理,包括依使用狀態 Load/Unload Model、釋放 VRAM,再依工作負載重新載入。
這代表地端 AI 的技術競爭,正在從「能不能跑模型」進一步走向:
如何有效管理企業有限且昂貴的 AI Computing Resources。
從 Copilot 到 Agent,權限必須逐級開放
當 AI 從回答問題進一步走向 Agent,治理要求也會隨之提高。
Wayne 將 Agent 的能力區分為:
Read → Analyze → Recommend → Execute
AI 可以先讀取資料,再進行分析與提出建議;真正涉及 ERP、MES 或其他核心系統寫回時,則需要更嚴格的授權與人工核准。
同時,Prompt、Response、Model Version、資料來源、使用者身分與批准紀錄,都應形成完整 Audit Trail。
企業需要的不只是知道「AI 做了什麼」,還必須能回答:
誰透過哪一版模型、以什麼權限、讀取哪些資料,最後產生了什麼決策。
這正是企業 AI 與一般生成式 AI 應用最大的治理差異。
從 AI Project 走向 Enterprise AI Infrastructure
對 Wayne 而言,企業 AI 架構最終可以歸納成四個核心:Foundation、Semantic、Identity、Accumulation。
Foundation 建立持續可用的數據基礎;Semantic 讓 AI 正確理解企業資料;Identity 確保 AI 遵循既有權限;Accumulation 則讓第一個 AI 專案建立的資料、語意與治理成果,可以直接被第二個、第三個 Agent 重複利用。
這也是企業從單點 AI Project 走向 AI Platform 最重要的差異。
當底層架構建立完成,新增 AI 應用不必重新串接一次 ERP、重新定義一次欄位、重新建立一套權限,而是在既有基礎上持續擴充。
模型決定 AI 能做到什麼,數據與治理架構則決定 AI 能不能真正進入企業核心。
對半導體與製造業而言,下一階段的競爭已不只是誰先部署 LLM,而是誰能更快建立一套可治理、可擴充、可持續累積的 Enterprise AI Infrastructure。