

雲端成本沒有天花板
雲端推論按 token 計費。AI 一旦展開到全公司,成本就線性累加、沒有上限。地端是一次性的資本支出,第一天起成本就可預測,典型約 12 個月回本(9–14 個月,依客戶試點與內部估算)。
產品 — AI Server
M1 到 M5 五種配置,從部門先導到主權級 AIDC。雲端按用量計費、沒有天花板;地端是一次性資本支出、第一天起成本可預測,典型約 12 個月回本。軟硬整合、開箱即用,用白話問數據、建知識庫、部署 AI Agent,不用組團隊、不用寫程式。
01
雲端推論按 token 計費。AI 一旦展開到全公司,成本就線性累加、沒有上限。地端是一次性的資本支出,第一天起成本就可預測,典型約 12 個月回本(9–14 個月,依客戶試點與內部估算)。
多數企業卡在「知道要做 AI、卻沒有人、沒有技術」。MICH 軟硬整合、開箱即用,白話問數據、自動建模、建知識庫、部署 Agent,不必先招一支團隊、不必寫程式。
製程參數、配方、客戶名單、研究數據,跑在公有雲就是把核心競爭力交到別人手上。地端讓數據留在廠內,斷網也能跑;對製造、醫療、政府、金融來說,數據外洩是合規風險,不是可有可無的小事。
02
廠務 IT 與營運
ERP、MES、現場數據不能離開廠房。需要斷網也能跑的 AI。沒有 AI 團隊,也要把製程、良率、排程的 AI 真正落地。
生技、醫療、政府、金融
數據主權是法規要求的產業。必須完全離線運作的環境。數據不能出廠、出院、出機房,主權與合規是底線。
赴美與海外設廠
在海外建置地端算力、跨國數據落地(GDPR 等)的企業。對這些客戶,可驗證、來源透明的供應鏈是進入當地採購的門票。
每一種配置都內含 LowsiteOS,把你的 ERP、MES、IoT 數據變成地端、可問答的智慧,連老師傅的經驗都能變成可查詢的知識。不經公有雲 API、數據不出廠。
了解 LowsiteOS03
M1–M2
在做 AI 先導、或只給一個團隊用?一台就能部署的單機,放進辦公室、診間或實驗室,不必機房、不必改建。
M2–M3
多個模型併行,或把 120B+ 模型放進單機。直接放進你現有的 5–7kW 機櫃,不必施工、不必等。
M4–M5
服務 200–500 人的私有 AI 數據中心,或國家級的旗艦模型訓練。只聽命於你的算力。
Starter
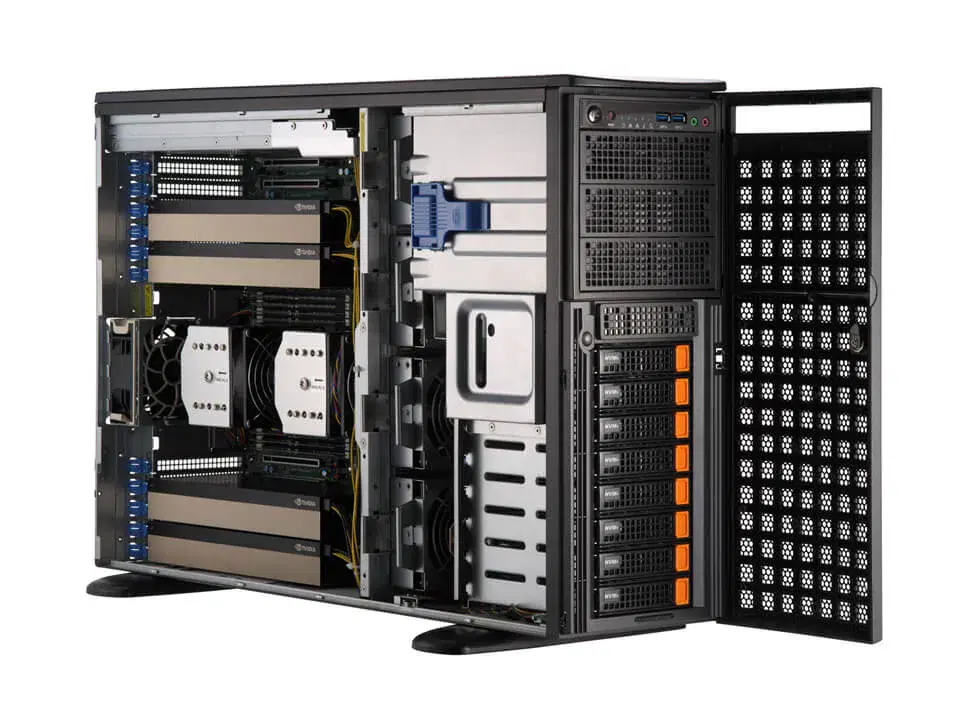
最適合
工程師在工作站旁就能跑模型,數據不離現場。90 天內就知道這個 AI 方向值不值得放大。
能跑什麼
知識庫 RAG、白話問數據 BI、語音 AI(Riva)、影像與醫療影像試點(Metropolis、Clara)。可跑 ≤70B 開源模型,192GB 配置可跑 120B。
Department
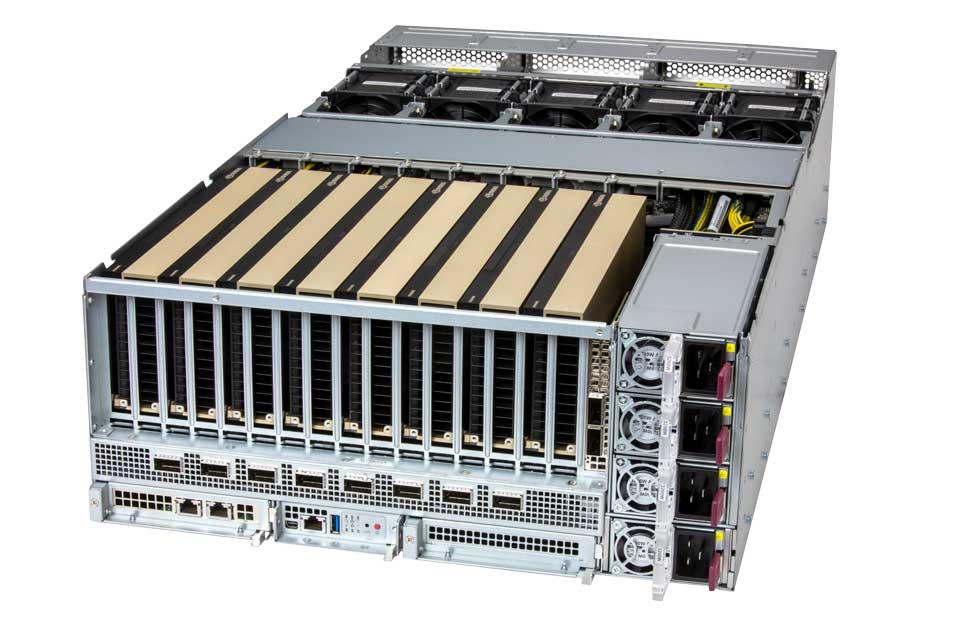
最適合
多個 AI 模型跨部門同時運轉。直接放進你現有的 5–7kW 機櫃,不必改機房、不必等基建。
能跑什麼
多個正式模型同時跑:客服語音(Riva)、排程優化(cuOpt)、即時資安(Morpheus)、全公司 RAG,全在一個機櫃裡。
Research
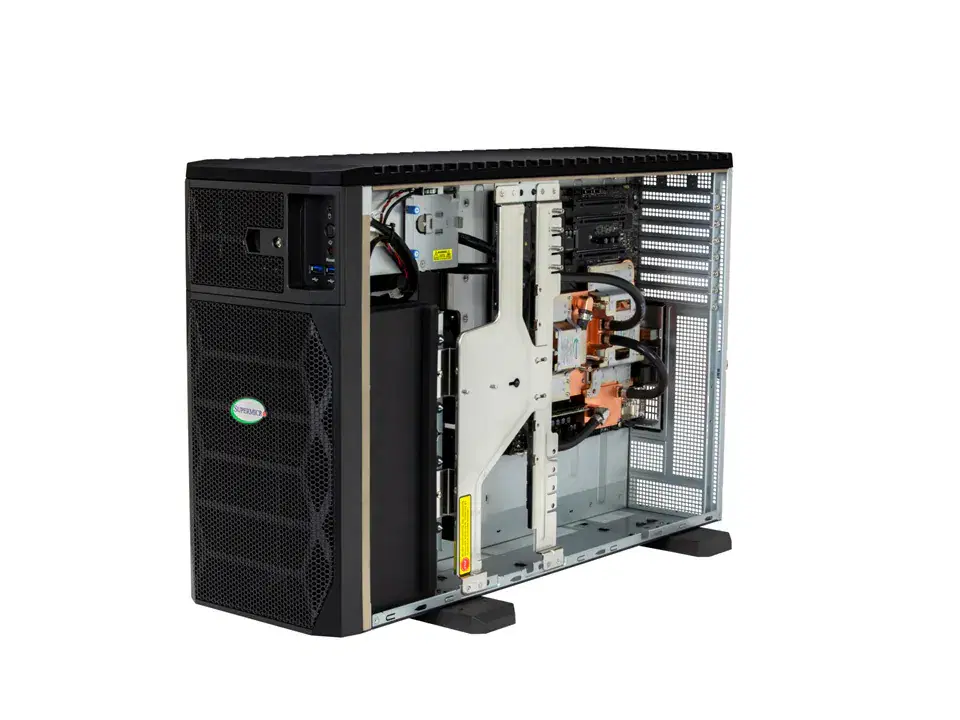
最適合
在單機上跑 120B+ 旗艦模型、不受 VRAM 瓶頸。可桌邊或實驗室部署,不必架高地板、不必特殊冷卻。
能跑什麼
120B+ 旗艦模型在 748GB 一致性記憶體中完整執行,再加上 Omniverse 數位孿生、BioNeMo/Parabricks 基因運算、Modulus 良率根因分析,全在一台。
AIDC
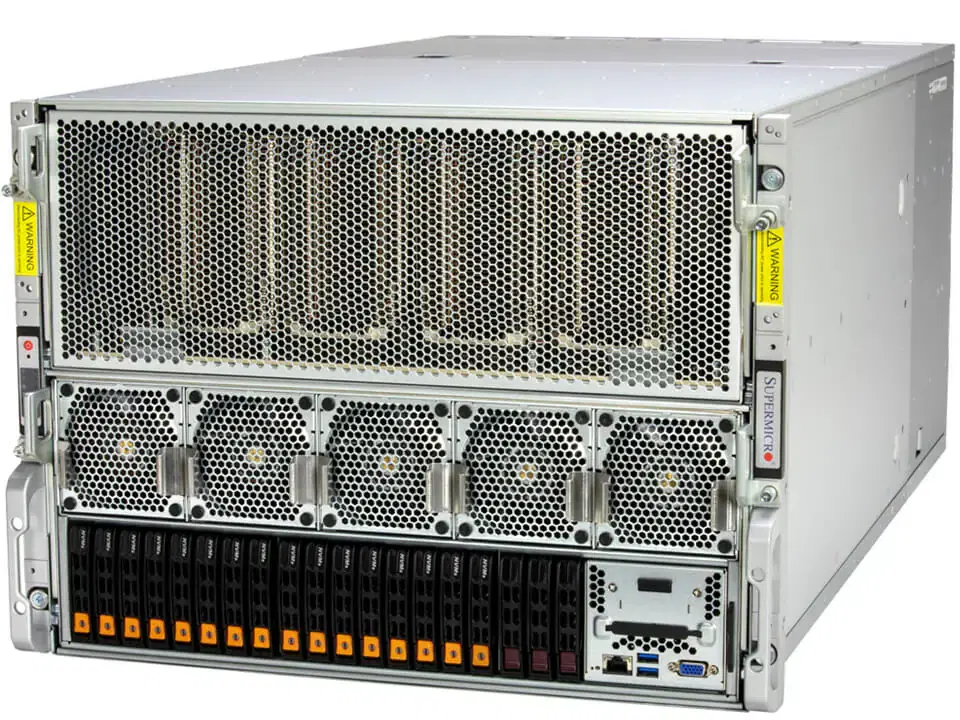
最適合
需要私有 AI 數據中心的組織:服務 200–500 人同時在線、跑多個大模型,算力主權不受任何供應商或政府中斷。
能跑什麼
200–500 人的多租戶正式生產:全行 RAG、即時詐欺/AML(Morpheus)、大規模語音、NeMo 微調,各部門隔離互不干擾。
AIDC Pro
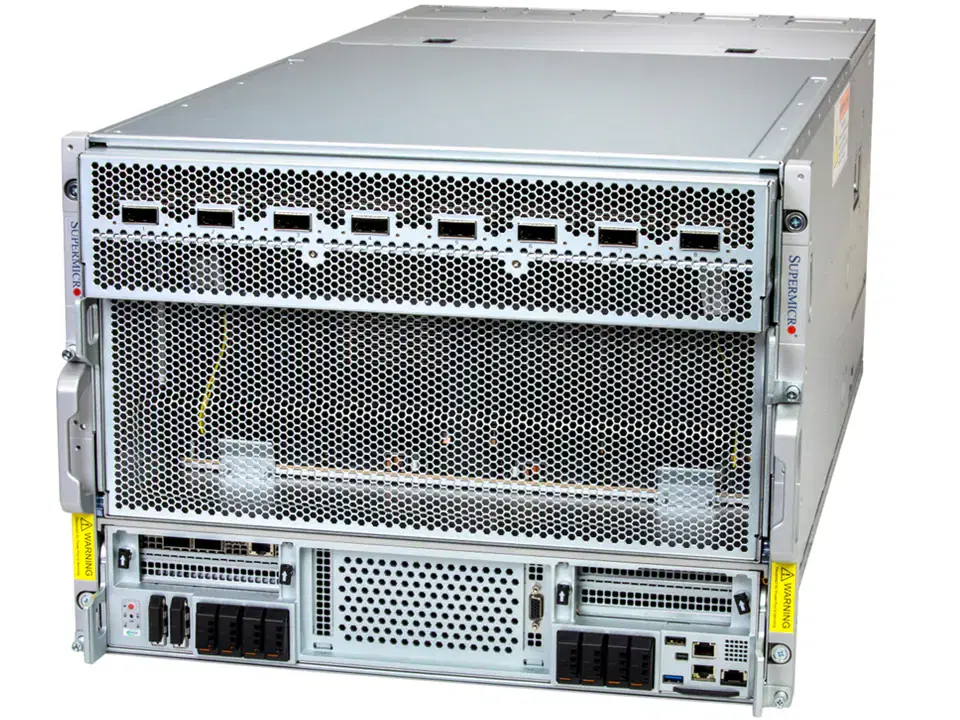
最適合
國家級 AI 部署、100B–1T+ 模型訓練、主權算力基礎建設。給「算力本身就是戰略資產」的組織,不是向別人租來的服務。
能跑什麼
100B–1T+ 模型訓練(NeMo)、800GbE 多節點集群、多廠區 Omniverse 協作、Earth-2 氣候/災防模擬,全是主權級規模。
規格
所有 tier 共用同一套 LowsiteOS 作業層。★ 為 Phase 1 主推機種。
| 機種 | GPU | VRAM / 記憶體 | 定位 | Lead (MICH) |
|---|---|---|---|---|
工作站系列· 桌邊 / 部門部署M1 · M3 | ||||
 | NVIDIA RTX PRO 6000 Blackwell ×1–2 | 96–192GB GDDR7 ECC DDR5 5600 up to 4TB | 邊緣 PoC / 開發團隊 · 桌邊 28dB 靜音 | ⚡ 1.5wvs 3w |
 | NVIDIA GB300 Grace Blackwell Ultra (Grace 72C + B300) | 748GB coherent (HBM3e + LPDDR5x) 496GB LPDDR5x SOCAMM (in coherent pool) | 研發核心 · 748GB 一致性記憶體單機 · 28dB | ⚡ 2.5wvs 6w |
機架式系列· 數據中心 / AIDC 部署M2 · M4 · M5 | ||||
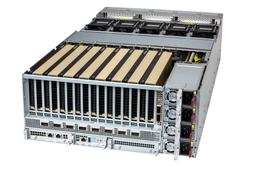 | NVIDIA RTX PRO 6000 Blackwell ×8 (PCIe · CX-8 switch) | 768GB GDDR7 ECC (96GB×8) DDR5-6400 up to 6TB | 部門級私有推論池 · 既有 5–7kW 機房免改造 | ⚡ 2wvs 4w |
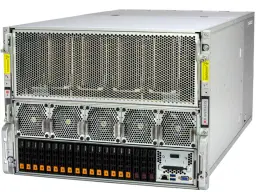 | NVIDIA HGX H100/H200 8-GPU (SXM5 · NVLink) | 1,128GB HBM3e (141GB×8) DDR5 5600 up to 8TB | AIDC 核心 · 多租戶 · 高吞吐 serving · 15kW 機櫃內 | ⚡ 4wvs 9w |
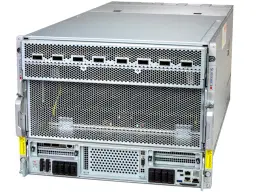 | NVIDIA HGX B300 8-GPU (NVLink 5 · 1.8TB/s) · Air-Cooled | 2.3TB HBM3e (288GB×8) DDR5 RDIMM up to 8TB | 主權 AI / 國家級算力 · 100B–1T+ 訓練與多模態研發 | ⚡ 5wvs 12w |
解決方案
每台 AI Server 都搭配對應的 LowsiteOS 服務分級(T1–T5)。選一階,看它內建的功能、可上線的應用場景與產業實例。
你的第一台地端 AI 主機。用白話問數據、自動生成儀表板、當天建好企業知識庫、部署 AI Agent,不用組團隊、不用寫程式。支援 ≤70B 開源模型(192GB 配置可跑 gpt-oss-120B)。
在自己的實驗室跑 BioNeMo 蛋白質結構與分子對接 PoC,數據不出大樓,數週內看到第一個結果,再決定要不要擴大。
※ 六大產業共同的入門起點
04總成本試算
別用猜的。Spec Advisor 會依你的工作負載與規模,推薦適合的 M 機型,並估算 3 年總成本與等值雲端支出的差距。
05可信賴的硬體與在地交付
每一台 MICH AI Server 都採用 100% 原廠標準通路的 NVIDIA、Intel、Supermicro 硬體,原廠保固完整;在台灣在地整合與交付,交期透明、有人 support。
標準通路
NVIDIA · Intel · Supermicro
100% 原廠一線品牌元件,非改裝、非白牌;序號可查、原廠保固完整。
台灣整合出貨
單一窗口・交期透明
在台灣在地整合與出貨,交期透明可預期。MICH 備有常用配置現貨,免排原廠的生產與 GPU 配額佇列,交期更短。
在地工程師
到場安裝・保固維運
在地工程師到場安裝與教育訓練,保固、維運與遠端監控;出問題找得到人。
06常見問題
關於成本、數據安全、交期與導入,整理買家最常問的問題。