然而,當市場持續關注模型能力與算力規格,企業真正開始導入後,往往才發現另一個更現實的問題:模型已經準備好了,數據卻還沒準備好。
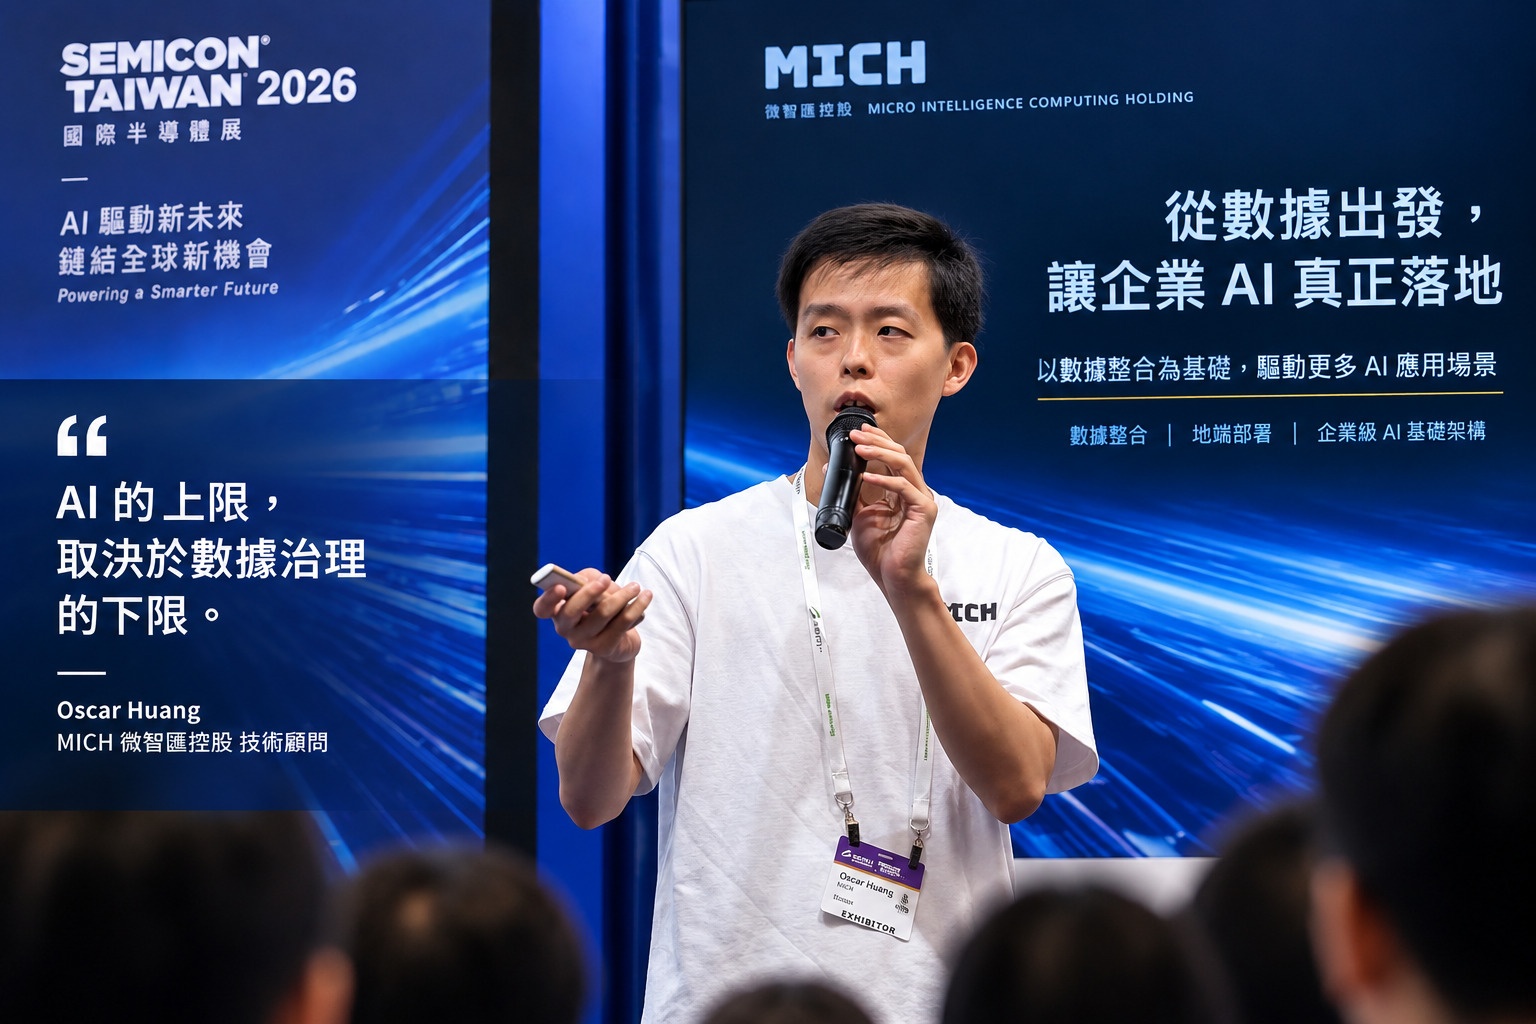
MICH 技術顧問 Oscar Huang 指出,企業導入 AI 時,真正耗費時間的往往不是模型開發,而是前期的數據工程。從調取資料、欄位對齊,到不同系統間的資料整合與驗證,都可能成為 AI 從概念驗證走向實際應用前的瓶頸。
這也讓企業開始重新思考一件事:AI 的上限,或許取決於數據治理的下限。
AI 上線之前,企業得先處理四道數據工程
在企業級 AI 導入過程中,資料通常分散於 ERP、MES、設備與其他既有系統。要讓 AI 真正使用這些資訊,前期仍須經過系統盤點、系統串接、異質系統合併與數據正確性驗證。
依 Oscar 過去參與企業級 AI 導入的顧問經驗,這段前置工作可能需要 3 至 6 個月。
更大的問題則出現在第一個 AI 應用之後。
如果企業為每一個 AI 專案各自建立資料來源與串接方式,當第二、第三個 Agent 出現時,相同的數據工程就可能不斷重複。短期看似能快速完成單一專案,長期卻容易形成新的資料孤島。
因此,企業真正需要建立的,不只是「一個可以使用 AI 的專案」,而是一套可以持續承接下一個 AI 應用的數據基礎。
不是省略數據治理,而是把重複工作縮短
針對企業 AI 前期大量的資料整合工作,MICH 透過 LowsiteOS Data Agent,將其中的「系統串接」與「異質系統合併」流程縮短至最快 1 小時。
但「快」並不代表所有工作都交給 AI。
系統盤點仍然需要企業理解自己的資料環境,最後的數據正確性驗證也不能被省略。尤其當 AI 開始參與生產與營運決策,錯誤資料帶來的不只是回答不準確,更可能直接影響使用者對 AI 系統的信任。
因此,縮短資料串接時間的目的,是讓企業把更多資源放在真正需要人判斷的資料品質與驗證工作,而不是反覆處理相同的系統整合。
第一個 AI 應用最花時間,第二個開始才是關鍵
當企業完成系統盤點、數據目錄與驗證規則後,這些基礎不應該隨著第一個 AI 專案結束而消失。
相反地,它們可以成為後續 AI 應用共用的數據底座。
當第二個、第三個甚至更多 Agent 上線時,企業不必重新進行相同的資料工程,而是沿用既有的資料結構與治理規則,逐步擴大 AI 的應用範圍。
這也讓企業評估 AI 投資的方式開始改變:不能只看第一個 AI 專案做得多快,而要看第一個專案完成後,留下了多少能被下一個應用繼續使用的基礎。
製造業的另一道門檻:最有價值的數據不能離開工廠
對半導體與製造業而言,數據整合之外,還有另一項現實限制。
製程參數、良率數據、客戶料號與設備 Log 等資訊,往往也是企業最敏感、最具競爭價值的資料。這些數據不適合任意離開企業內部環境,也使 AI 的部署位置成為架構設計的一部分。
因此,MICH 選擇讓 LowsiteOS 與 AI Server 部署在企業內部,使 AI 能直接使用廠內數據,而不必先把核心資料送往外部環境。
這背後其實是一個不同的 AI 導入思維:
不是把企業最重要的數據搬去找 AI,而是讓 AI 走向數據。
當企業開始從一個 AI PoC 走向多個 Agent,真正決定規模化速度的,可能不再只是用了哪一個模型,而是底層的數據能否被安全、正確,而且持續地重複使用。
這也正是企業 AI 從「做出一個 Demo」,走向真正進入核心營運流程時,必須跨過的一道門檻。