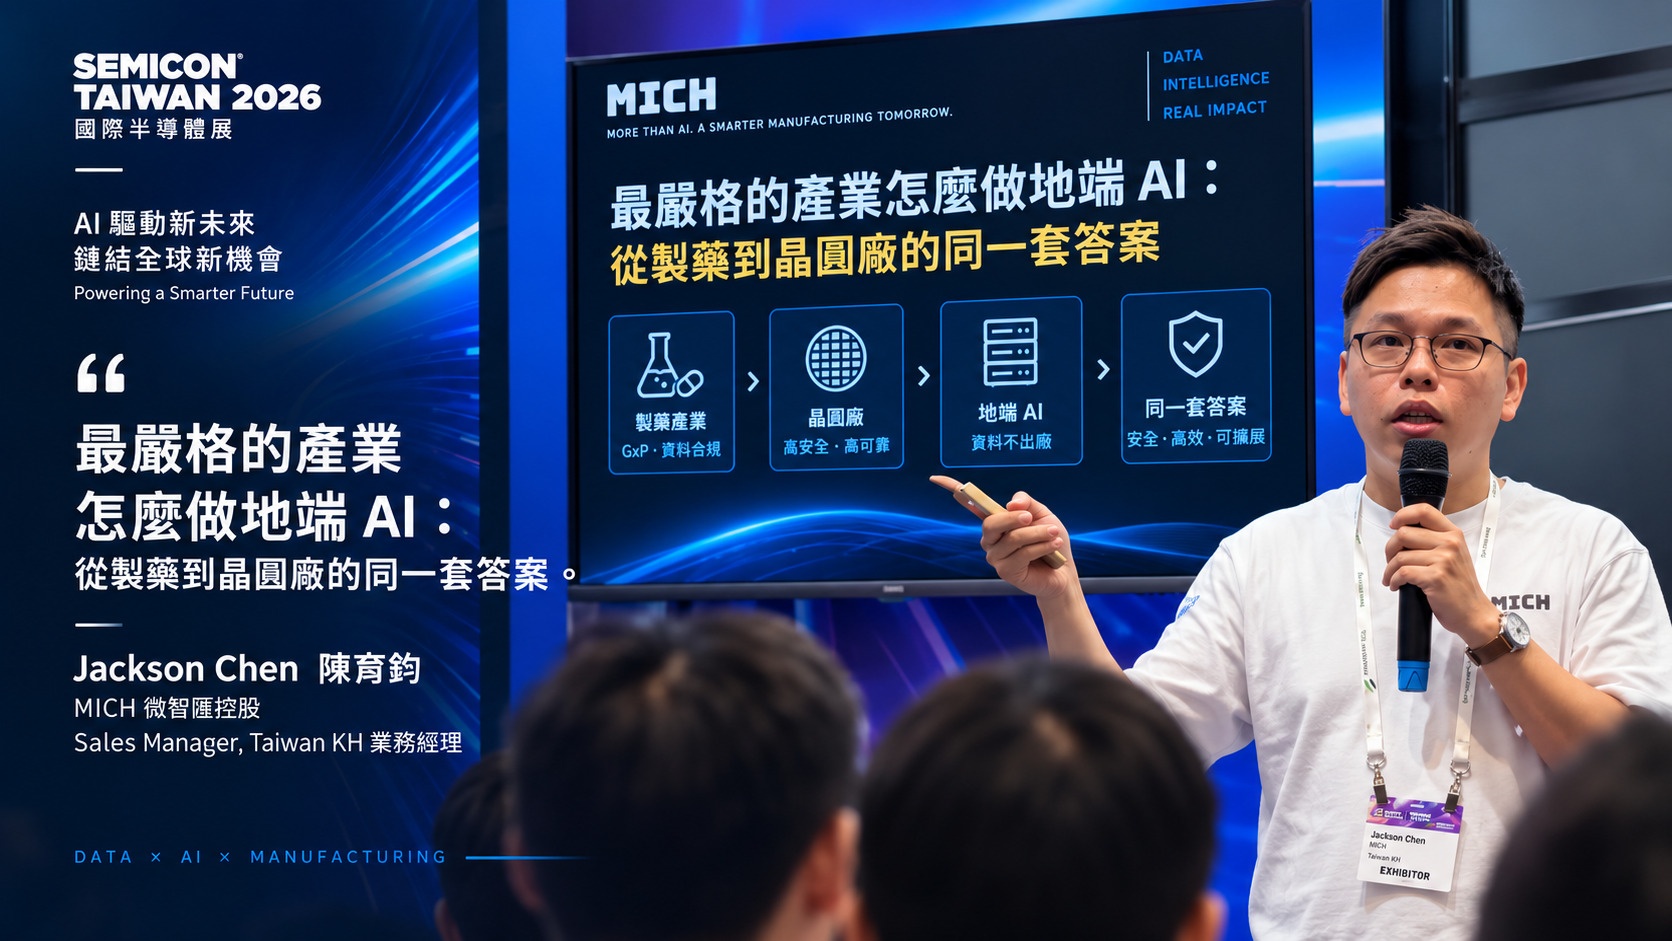
如果要找一個足以壓力測試企業 AI 治理架構的產業,製藥業幾乎是最嚴苛的場景之一。
一款新藥從發現、臨床試驗到最終上市,研發週期可能長達 10 至 15 年;過程涉及多階段驗證,投入成本更可能達數十億美元。這意味著,任何一個錯誤方向如果太晚才被發現,付出的都不只是運算成本,而是數年的研發時間與龐大資源。
也因此,AI 在製藥業真正展現的價值,並不是取代科學家或跳過實驗,而是將部分判斷往研發流程前端移動,更早縮小可能的答案範圍。
AI 加速的不是「省略驗證」,而是更早排除錯誤方向
從蛋白質結構預測、候選分子生成,到分子與標靶的結合模擬,AI 可以協助研究團隊從龐大的候選空間中進行篩選,再由科學家決定哪些方向值得進入後續實驗。
這樣的技術路徑改變了一件重要的事:運算速度可以被大幅壓縮,但驗證本身不能消失。
Francis Crick Institute 的 TRACERx EVO 癌症研究就是一個代表案例。研究團隊透過 NVIDIA Parabricks 加速基因體資料處理,公開案例指出,相較原有 HPC 服務的估算,專案累積可節省接近 9 年的處理時間,同時維持比較品質指標的一致性。
對高度監管產業而言,這個案例真正值得關注的並不只是「快了多少」,而是速度提升與結果可信度必須同時成立。
這也是企業 AI 與一般消費型 AI 最大的差異之一。當 AI 開始影響研發、生產、品質甚至營運決策,企業需要的不只是答案,而是知道答案建立在哪些資料與規則之上,並保留後續驗證與追溯的能力。
模型愈來愈強,真正拖慢 AI 的卻可能是「數據摩擦」
近年基礎模型與 GPU 算力快速進步,但進入企業內部後,AI 導入速度不一定因此等比例提升。
其中一個原因,就在於數據摩擦。
製藥企業的資訊可能分散在 ELN、LIMS、ERP、研究文獻、專利與實驗設備;資料雖然存在,卻可能面臨格式不同、系統彼此獨立、權限分散與資料語意不一致等問題。
類似情況也存在於製造現場。
ERP 保存訂單與物料資訊,MES 掌握生產執行,設備持續產生 Log 與製程參數,品質系統保存檢驗結果,工程知識則散落於 SOP、圖面與人員經驗。
因此,AI 真正進入企業之後,競爭焦點逐漸從單純的模型能力,轉向企業能否讓模型安全、正確且持續地取得自己的數據。
Drug Formula 到 Process Recipe,兩個產業共享同一套治理邏輯
製藥與半導體的產品完全不同,但從企業 AI 架構來看,兩者存在高度相似性。
製藥產業的 Drug Formula 對應半導體的 Process Recipe;ELN、LIMS 所承載的研發與實驗資料,對應製造端 ERP、MES 與設備系統形成的生產資訊;製藥業長期建立的 GxP 與品質管理要求,也能映射到晶圓製造對製程治理、權限、品質與追溯性的高度要求。
兩個產業共同面對的核心條件,都是敏感資料不能任意外流、存取權限必須受到管理、關鍵結果需要被驗證,AI 行為則必須留下足以追溯的紀錄。
產業不同,但底層的 AI 治理邏輯並沒有太大差異。
這也是製藥經驗對半導體產業最有價值的地方。AI 不需要因為產業高度敏感而被排除,真正需要建立的是一套足以讓 AI 在既有治理要求下運作的架構。
過去十年,企業完成的是「數位化」
從市場角度來看,過去十年的製造業與企業數位轉型,大量投資其實集中在一件事情:把原本不存在系統裡的資訊變成數據。
製造業陸續建立 ERP、MES、WMS、APS,設備開始聯網,紙本報工逐步數位化;製藥業也透過 ELN、LIMS 與各種研究資訊系統,持續累積更完整的數位研發紀錄。
這十年的核心,是讓實體世界產生的流程、事件與知識留下數位足跡。
企業因此建立了大量數位資產,也為今天的 AI 應用準備了過去不存在的數據基礎。
但到了 2026 年,市場正在進入下一個階段。
企業已經從「缺乏數據」,走向「擁有大量數據,卻還沒有充分使用」的新階段。
未來十年,企業競爭將從「累積數據」走向「讓 AI 使用數據」
如果過去十年的核心是 Digitalization,那麼未來十年的企業競爭,很可能進一步走向 AI-Ready。
企業不再只追求更多數據,而是需要讓既有數據具備被 AI 安全使用的條件。
資料來源與語意需要被理解,不同使用者與 Agent 必須遵循既有權限,AI 使用過哪些資料需要留下紀錄,答案必須具備追溯依據;即使未來模型更換,企業累積的數據與治理基礎也不應因此重新建立。
這些能力開始讓 On-Prem AI 的市場定位發生變化。
地端 AI 過去經常被理解為「資料不上雲」的資安方案,但當 AI 開始進入核心營運,它真正代表的是企業對數據、模型、權限與 AI 行為的控制能力。
對製藥、晶圓製造以及半導體供應鏈而言,這項能力將愈來愈接近企業 AI 基礎設施,而不只是單純的部署選項。
LowsiteOS:讓 AI 走向數據,而不是讓核心數據離開企業
這也是 LowsiteOS 所採取的架構思維。
傳統雲端 AI 的資料流向,通常是把企業資訊送往模型所在的環境;對高度敏感的產業而言,更適合的方向則是反過來——讓 AI 模型走向企業數據。
LowsiteOS 透過地端部署,串聯 ERP、MES、設備、文件與企業知識,建立可供 AI 使用的企業數據基礎,再讓不同模型與 AI Agent 在企業可控的環境中運作。
如此一來,企業建立的不是一個單獨的 AI 專案,而是一套可以持續承接不同應用的底層架構。
第一個應用可能是企業知識 Agent,後續可以延伸至品質分析、設備維護、生產決策或研發知識搜尋。應用與模型可以持續更換,但底層的企業數據、權限與治理機制可以被保留下來。
這也使 AI 導入從過去的單點應用,逐漸形成一條更完整的企業架構:
企業數據 → 地端數據治理 → AI 模型 → AI Agent → 產業應用
從製藥到晶圓廠,AI 的下一個門檻是「可信任」
製藥業提供了一個很有價值的產業參照。
即使面對漫長研發週期、高昂失敗成本,以及嚴格的品質與法規要求,AI 仍然開始進入研發流程。真正改變的並不是原有驗證標準被取消,而是產業開始建立更完整的 AI 使用邊界與治理方式。
這項趨勢映射到晶圓廠與半導體供應鏈,同樣成立。
AI 從 PoC 走向核心製程之後,模型效能只會是基本條件之一。數據能否留在企業、權限能否被控制、結果能否被驗證、行為能否被追溯,將共同決定 AI 能走進多深的企業流程。
過去十年,企業的任務是把實體世界轉換成數據。
未來十年,則會是讓 AI 在可信任、可治理的條件下理解並使用這些數據。
而製藥與晶圓製造這兩個高度重視機密、品質與治理的產業,反而可能比其他產業更早定義出企業 AI 真正成熟後應該具備的樣貌:
數據留在企業、AI 走向數據;模型持續進化,但企業對數據與決策的控制權始終留在自己手上。